16 de novembro de 2026 - 6 min de leitura
Sentinel reconstruído: uma página de status para seus stakeholders
Nosso monitor open source para engenheiros de DevOps agora parece um produto pronto: página de status pública, incidentes com post-mortem e agentes.
O Sentinel, o monitor que construímos para os sistemas que operamos, tem uma nova versão. Ele é uma ferramenta para engenheiros de DevOps, e agora é uma página de status que você pode enviar para quem depende dos seus serviços, um lugar para registrar incidentes e seus post-mortems, e uma ferramenta em que você e seus agentes trabalham todos os dias. Ele finalmente tem a cara do que já tinha se tornado: um produto pronto.
Por que construímos um monitor
O Sentinel existe por causa de uma lacuna em que caíamos sempre. Os clientes precisavam de monitoramento, nós precisávamos enxergar o que acontecia nas plataformas que operamos, e boa parte das verificações de que precisávamos não era sobre um servidor responder. Era sobre os dados estarem certos.
Um sistema de verdade falha de jeitos que um ping nunca vê. Os nossos lidam com dados geoespaciais, então os exemplos vieram rápido. A API responde 200 enquanto a grade de previsão por trás dela está seis horas atrasada. O endpoint de tiles está no ar, mas a camada de radar que ele serve parou de atualizar de madrugada. Uma rodada de modelo nunca chegou ao bucket. Um workflow no cluster não terminou, então nada depois dele vai terminar. Um caster GNSS está online, mas metade das estações de referência sumiu da sourcetable.
Testamos as ferramentas de sempre: Gatus, Uptime Kuma, New Relic. Cada uma chegava a uns 90%. Os 10% que faltavam eram sempre a mesma parte: verificações que entendem os dados. Então escrevemos um monitor em que uma verificação é uma função curta em JavaScript, com um pequeno kit para exatamente esses casos: HTTP, FTP, armazenamento compatível com S3 (baixar um objeto, listar um prefixo, ler suas datas), Kubernetes (o CronJob ou o workflow do Argo terminou?) e segredos. Se você consegue escrever a asserção, o Sentinel executa em um agendamento, guarda o histórico e avisa quando muda.
Por que ele precisava ser reconstruído
O Sentinel cresceu do jeito que crescem as ferramentas feitas sob pressão: uma necessidade de cada vez. Cada funcionalidade chegou com sua própria tela e suas próprias palavras para a mesma coisa. "Fora do ar" numa página era "crítico" em outra e "falhando" num alerta. Funcionava, mas tinha a cara do que era, um Frankenstein, e não era algo que você mandaria para um cliente.
Esta versão reconstrói todas as páginas sobre um único design system e um único vocabulário:
- Uma verificação está Operational (operando), Degraded (degradada) ou em Outage (fora do ar); Recovered (recuperada) quando voltou nas últimas 24 horas; Paused (pausada) quando está desligada.
- Todo estado é uma forma e uma palavra: um círculo, um triângulo, um quadrado. A cor nunca carrega um estado sozinha, então a página se lê igual para quem é daltônico e numa impressão em tons de cinza.
- As mesmas palavras aparecem em todo lugar: no painel, na página pública, nos alertas de Slack e Discord, no e-mail e no que os agentes leem.
- Temas claro e escuro, horários em UTC ou locais, e páginas que funcionam no celular.
Uma página para enviar
A página de status pública agora é a porta de entrada. Ao abrir o endereço, é ela que você vê: um resumo no topo, os incidentes abertos e depois cada verificação agrupada por estado, com o histórico de 24 horas, 7 dias ou 30 dias. As tags viram páginas próprias, então uma equipe pode compartilhar só as verificações que interessam a um parceiro ou a um produto.
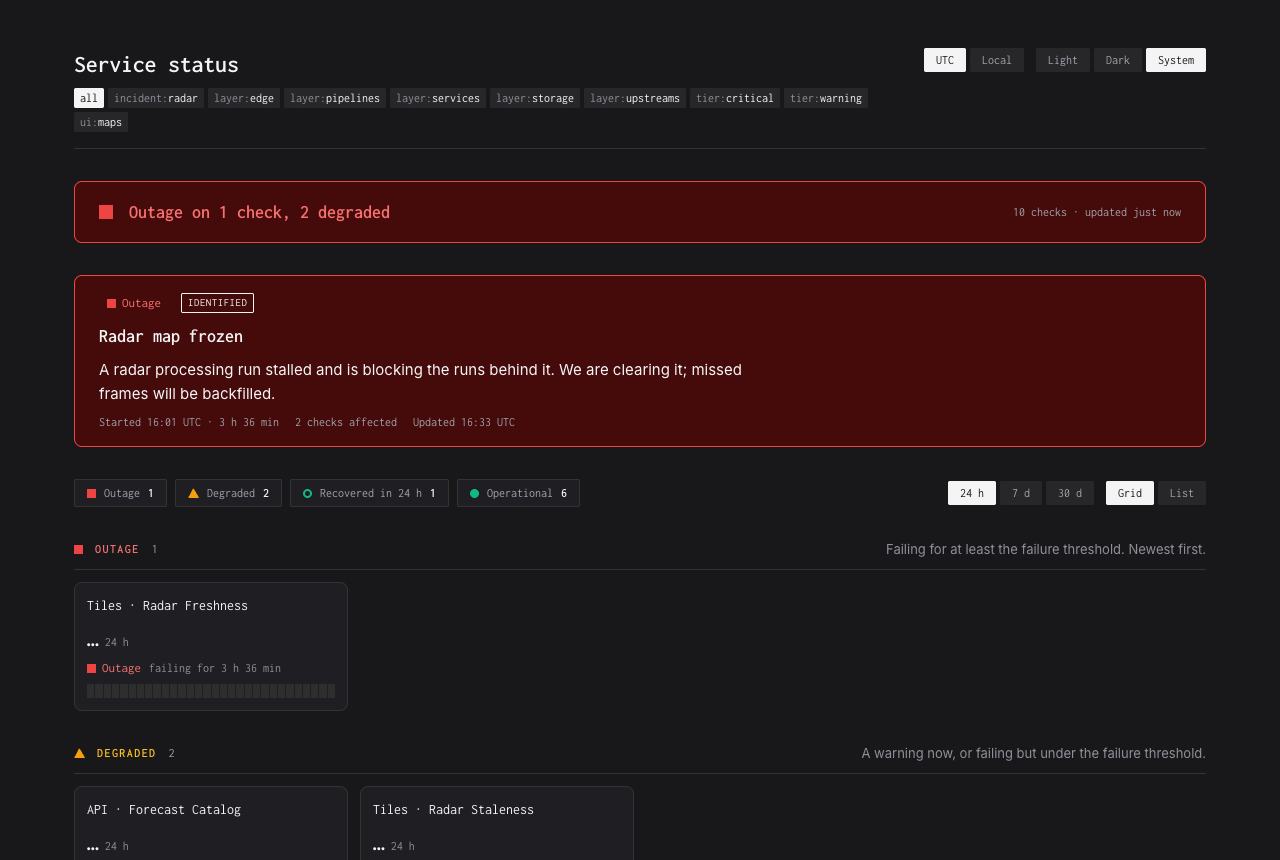
Ela foi feita para ser enviada. Mensagens de erro internas nunca chegam à página pública, a página se atualiza sozinha a cada minuto, e quem a abre às 3 da manhã entende o que importa sem ligar para ninguém: o que foi afetado, desde quando e o que está sendo feito.
Incidentes que ficam registrados
A maior novidade são os incidentes. Quando uma verificação entra em Outage, o Sentinel abre um incidente sozinho. Verificações que compartilham uma tag incident:<grupo> compartilham um incidente, então uma rodada de processamento travada, que congela a camada de radar e os tiles gerados a partir dela, vira um incidente, não dois alarmes. Ele é resolvido quando todas as verificações ligadas voltam a Operational.
Cada incidente tem uma linha do tempo (o que o sistema viu e as notas das pessoas) e um relatório em cinco seções, com uma versão interna e uma pública. Você guarda o post-mortem completo para a equipe e publica a parte de que quem depende de você precisa.
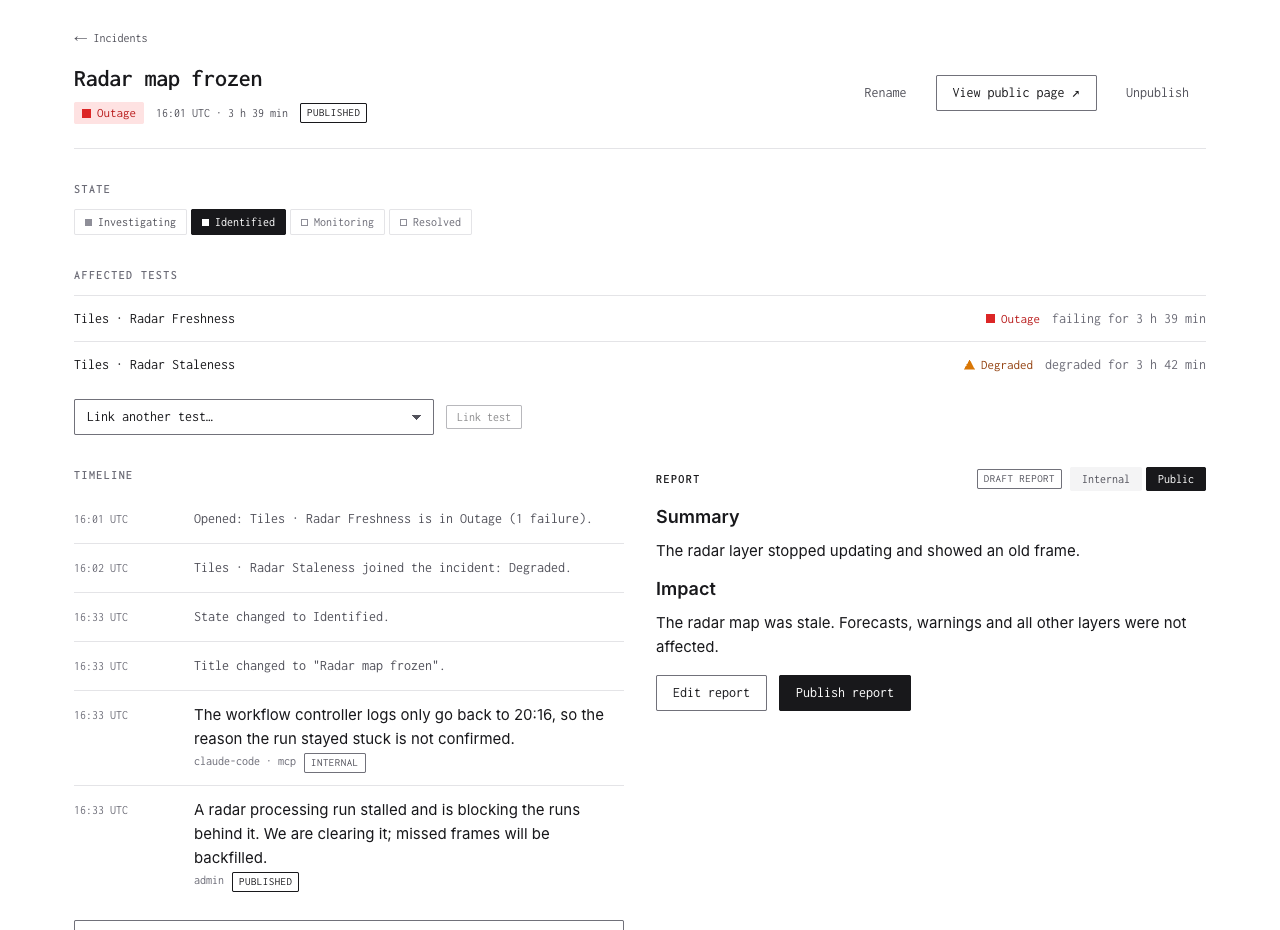
Publicar é, de propósito, uma decisão de uma pessoa. Qualquer um, ou qualquer agente, pode escrever notas e rascunhos; só alguém autenticado coloca um incidente, uma nota ou um relatório na página pública.
Feito para as pessoas e os agentes que operam o sistema
O Sentinel é uma página pública, mas antes de tudo é uma ferramenta de DevOps. O painel agora tem busca, filtros e ações em lote, então revisar dezenas de verificações depois de um deploy leva poucos cliques.
Ele também fala MCP, o protocolo que agentes de IA usam para trabalhar com ferramentas. Trabalhamos todos os dias com o Claude conectado ao Sentinel: ele lê o estado de cada verificação, abre e anota incidentes, rascunha o relatório e roda as verificações de novo depois de uma correção. É assim que detectamos o que acontece nas nossas plataformas e mantemos o registro. O agente vê as mesmas palavras que você, e não publica nada por conta própria.
Por baixo da cara nova também houve uma rodada de confiabilidade: gravações em lote, timeout em todo alerta, páginas públicas em cache e um agendador que mantém o ritmo entre reinícios. Ele continua rodando com folga numa máquina virtual de 1 GB, ao lado do seu banco de dados.
Como usar
O Sentinel é open source sob a AGPL v3, em github.com/territorial-dev/sentinel, com uma imagem Docker que sobe com um docker compose up.
- Hospede você mesmo, do jeito que está, na sua infraestrutura.
- Faça um fork e deixe com a sua cara: sua marca, seus próprios protocolos, suas próprias páginas. Na semana que vem mostramos como, e por que continua fácil de atualizar.
- Use em um produto fechado ou ofereça como serviço com uma licença comercial.
- Ou deixe que a gente opere para você, com as verificações de que os seus dados realmente precisam.
A ferramenta nunca foi o ponto. Monitorar um sistema é verificar o que ele entrega, não só se ele responde: o quão recentes estão os dados, se a rotina da madrugada terminou, se cada fonte externa continua lá. É essa parte que engenheiros de DevOps acabam resolvendo com scripts na mão, e é por isso que o Sentinel existe.