22 de abril de 2026 - 4 min de leitura
Pare de escolher entre cron jobs e pipelines complexas demais
Por que a maioria das pipelines geoespaciais falha em produção, e como uma camada de workflow mais simples pode trazer confiabilidade sem complexidade desnecessária.
A decisão que a maioria dos times erra
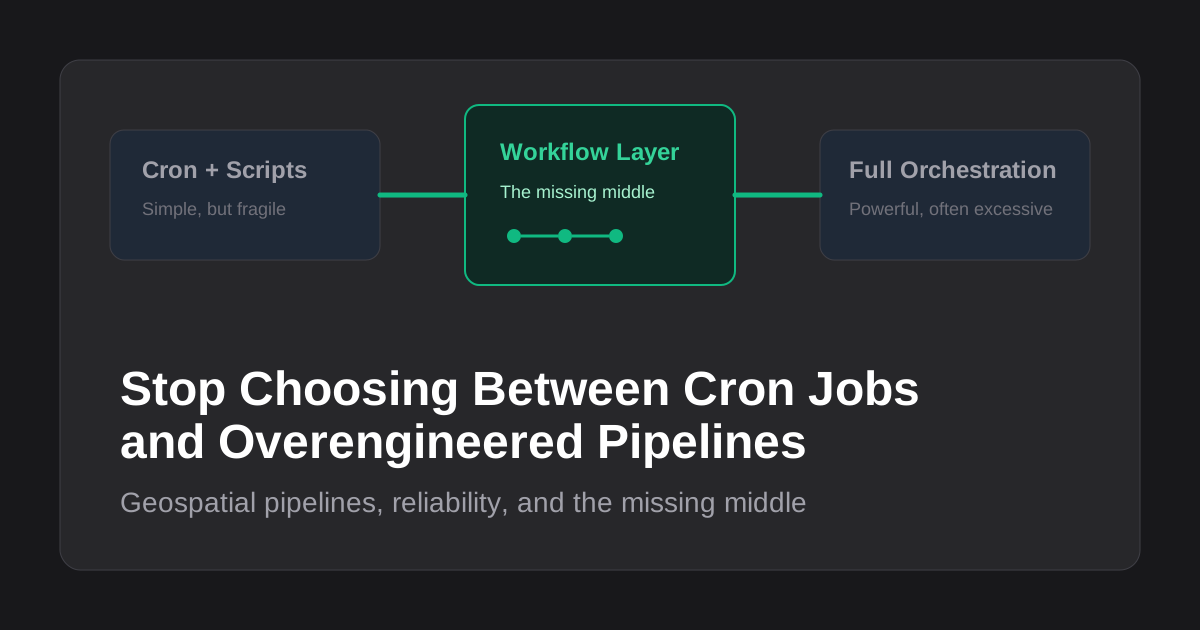
A maioria dos times que constrói pipelines geoespaciais acaba em um de dois extremos: scripts com cron jobs que "simplesmente funcionam" ou plataformas de orquestração completas, pesadas de construir e operar.
As duas abordagens são comuns. Nenhuma é um bom padrão inicial.
O problema real não é falta de ferramenta. É escolher complexidade com base na escala percebida, e não nas necessidades operacionais.
Isso aparece em dois cenários recorrentes:
- atualizações de radar publicadas a cada 10 minutos em NetCDF, depois transformadas e publicadas para visualização no mapa;
- dados cadastrais no PostGIS que precisam ficar sincronizados com vector tiles no S3, com atraso aceitável de cerca de 10 minutos.
As cargas são diferentes, mas o erro é parecido: subestruturar o fluxo mais leve e superengenheirar o mais pesado.
Dois extremos que não escalam
A combinação script + cron é rápida para começar, mas frágil em produção. Ela assume que os dados chegam no horário, que cada etapa vai funcionar e que falha é exceção.
Na prática, falhas são normais. O resultado costuma ser quebra silenciosa, saída parcial e debug demorado.
No outro extremo, plataformas como Argo Workflows trazem retries e controle explícito, mas também aumentam custo operacional, overhead de infraestrutura e tempo de iteração para muitos times geoespaciais.
Nos dois casos, o problema é o mesmo: desalinhamento entre complexidade do sistema e restrições reais.
O meio-termo que faltava
Existe uma terceira opção: uma camada de workflow que adiciona estrutura sem excesso de complexidade.
No nosso caso, essa camada é o n8n. As pipelines passam a ser workflows explícitos, com estado visível, ordem de execução controlada e caminhos de retry. O modelo deixa de ser "rodar scripts por agenda" e vira "executar workflows por estado e eventos".
Para suportar cargas geoespaciais, usamos um ambiente customizado com GDAL, PDAL, Tippecanoe e QGIS. Processamento e orquestração ficam na mesma camada, com mais consistência operacional.
Onde isso impacta a operação
O ganho aparece com clareza quando algo quebra.
Em um incidente real, recebemos uma ligação às 2 da manhã: "o radar parou de aparecer no mapa". A causa raiz era simples (entrada upstream inválida), mas rastrear o problema em uma stack mais complexa levou quase uma hora.
Esse é o ponto central: confiabilidade não basta quando diagnosticar é lento.
Com uma abordagem workflow-first, o ponto de falha é explícito, os inputs intermediários são inspecionáveis e os reruns são direcionados. O time sai de forense em log para operação controlada com visibilidade.
De workflows para sistemas: apresentando o Ordo
Quando a execução estabiliza, o próximo gargalo passa a ser padronização.
Entre projetos, os mesmos padrões se repetem (ingestão, processamento, transformação e publicação), mas cada pipeline acaba sendo reimplementada com pequenas variações.
Foi daí que surgiu o Ordo, uma camada de controle acima da execução.
O Ordo não é mais um motor de workflow. Ele define, valida e rastreia pipelines como jobs estruturados. As pipelines são modeladas como DAGs determinísticos, com contratos explícitos por etapa e artefatos nomeados.
Uma definição de pipeline no Ordo é, essencialmente, uma receita:
- uma sequência de etapas tipadas
- bindings explícitos de entrada e saída entre essas etapas
- parâmetros declarados (sem valores concretos)
- e um fluxo de artefatos totalmente definido, do início ao fim
Em tempo de execução, os jobs instanciam essas receitas com inputs concretos e saídas esperadas. A execução pode continuar no n8n, enquanto o Ordo permanece como fonte de verdade para estrutura e estado.
Na prática, isso remove lógica implícita:
- chega de adivinhar qual etapa produziu qual arquivo
- chega de passagem ad-hoc de parâmetros entre scripts
- chega de dependências de dados pouco claras
- chega de definições de pipeline duplicadas entre projetos
Em vez disso, as pipelines se tornam explícitas, inspecionáveis e repetíveis.
Se o n8n oferece uma forma de executar workflows, o Ordo oferece uma forma de defini-los com estrutura, garantir corretude antes da execução e acompanhar seu estado durante a execução.
Conclusões
Pipelines geoespaciais costumam falhar não por falta de ferramenta, mas por complexidade mal ajustada ao problema.
Abordagens com script são simples, mas frágeis. Orquestração completa é poderosa, mas frequentemente excessiva. A camada de workflow é o meio-termo prático para combinar confiabilidade, visibilidade e velocidade de iteração.
E, quando a execução estabiliza, padronização vira o próximo ponto de alavancagem, que é onde o Ordo entra.
Próximo passo
Se você está lidando com atualizações pouco confiáveis, correções manuais ou visibilidade limitada, o problema geralmente é estrutural, e não específico de ferramenta.
Já implementamos essa abordagem em diferentes ambientes e casos de uso. Se fizer sentido, podemos revisar seu setup atual e identificar seus principais gargalos.